DevOps-чаты и профессиональные сообщества помогают инженерам решать проблемы с инфраструктурой, обсуждать архитектуру, разбираться в ошибках Kubernetes, Docker, Terraform и CI/CD. Но лучший чат — не обязательно самый большой: для диагностики конкретного инструмента профильное сообщество часто полезнее общей группы с тысячами участников.
Если вам нужен русскоязычный DevOps-чат в Telegram, можно начать с DevOps — русскоговорящее сообщество. Для вопросов по контейнерам существуют отдельные группы Docker и Kubernetes, а проблемы с Infrastructure as Code удобно обсуждать в Terraform RU или на HashiCorp Discuss.
При этом профессиональное сообщество не заменяет мониторинг, техническую документацию и внутренние процедуры реагирования на инциденты. Чтобы получить полезный ответ, необходимо определить, где возникла проблема, подготовить диагностические данные и безопасно сформулировать вопрос.
В статье собраны площадки для DevOps, SRE и платформенных инженеров, таблица выбора сообщества под конкретную задачу и практические рекомендации по обращению за помощью.
Куда обращаться DevOps-инженеру: быстрый выбор сообщества
Если вы уже знаете, с каким инструментом связана проблема, используйте эту таблицу.
| Технология или задача | Сообщество | Для чего подходит |
|---|---|---|
| Общие вопросы DevOps, облака, инфраструктура | DevOps RU — Telegram | Обмен опытом, инструменты, архитектура, эксплуатация |
| Kubernetes, Helm, кластеры, сетевые плагины | Kubernetes RU | Ошибки Kubernetes, конфигурации и обновления |
| Docker, образы, контейнеры | Docker RU | Docker Engine, Docker Compose, контейнеризация |
| Terraform, IaC, провайдеры | Terraform RU, HashiCorp Discuss | State, модули, зависимости, поведение провайдеров |
| Kubernetes, вопросы к сообществу проекта | Kubernetes Discuss, Kubernetes Slack | Глубокие технические вопросы и обсуждения экосистемы |
| GitLab CI/CD | GitLab Forum | Pipeline, GitLab Runner, конфигурация CI |
| Docker, сложные ошибки | Docker Community Forums | Подробная диагностика, повторяющиеся ошибки |
| SRE, надёжность, on-call | Reddit r/sre | Инциденты, SLO, наблюдаемость, культура эксплуатации |
Не стоит вступать во все сообщества сразу. Выберите основной чат по вашему стеку и дополнительную площадку для сложных вопросов.
Главный принцип: чат подходит для обсуждения гипотез, форум — для сохранения подробного технического разбора, а официальная поддержка и внутренние процедуры — для критичных инцидентов.
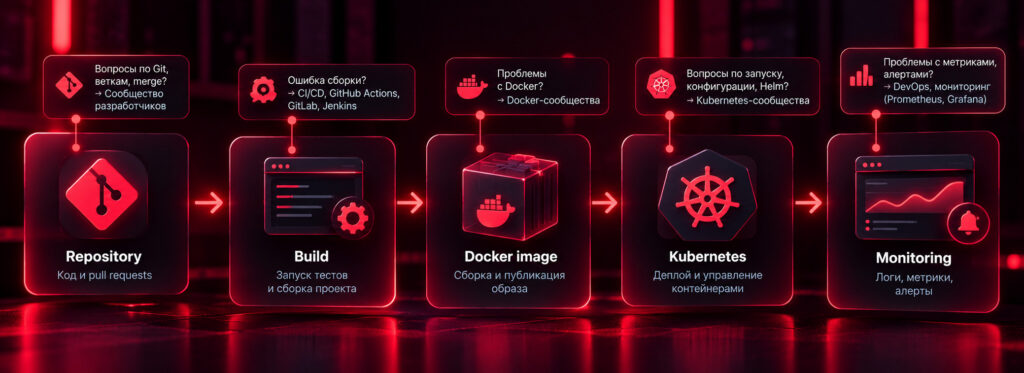
Русскоязычные DevOps-чаты в Telegram
Telegram остаётся удобным форматом для профессионального общения: можно быстро уточнить поведение инструмента, обсудить подход к инфраструктуре или найти инженеров с похожим опытом.
Но у групп разная специализация, поэтому важно правильно выбрать первую точку обращения.
DevOps — русскоговорящее сообщество
Ссылка: t.me/devops_ru
Крупное русскоязычное сообщество, посвящённое DevOps, мониторингу, метрикам и облачным технологиям.
Подходит для вопросов, затрагивающих несколько инструментов одновременно:
- Выбор подхода к автоматизации инфраструктуры.
- Организация CI/CD в команде.
- Миграция между облачными провайдерами.
- Мониторинг сервисов и инфраструктуры.
- Опыт внедрения GitOps.
- Организация on-call и процессов эксплуатации.
Например, здесь уместно обсудить компромиссы между self-hosted и managed Kubernetes или подходы к организации секретов в пайплайнах.
Однако отправлять в общий чат сотни строк логов падающего Pod не всегда эффективно. Для таких задач лучше выбрать профильную группу.
В описании сообщества также указана отдельная площадка для вакансий — @devops_jobs. Это важно учитывать, чтобы не нарушать правила технического чата.
Kubernetes — русскоговорящее сообщество
Ссылка: t.me/kubernetes_ru
Тематический чат по Kubernetes, его конфигурации, обновлению и эксплуатации.
Здесь уместны вопросы о:
CrashLoopBackOffиImagePullBackOff.- Настройке
Deployment,StatefulSet,DaemonSet. - Работе
Ingressи сетевых политик. - Helm-чартах и конфигурациях.
- Resource requests и limits.
- Проблемах с PVC и StorageClass.
- Обновлениях кластеров и совместимости компонентов.
Если проблема касается конкретного механизма Kubernetes, лучше сразу обратиться сюда, а не начинать с общего DevOps-чата.
При этом учитывайте разделение ответственности: ошибки managed-кластера, вызванные внутренними ограничениями облачного провайдера, могут потребовать обращения в его поддержку.
Docker — русскоговорящее сообщество
Ссылка: t.me/docker_ru
Группа для обсуждения Docker, Docker Swarm и контейнерной экосистемы.
Подойдёт для вопросов по Dockerfile, Compose, сетям контейнеров, томам, работе Docker Engine и сборке образов.
Например:
- Почему контейнер завершается сразу после запуска?
- Как уменьшить размер образа?
- Почему приложение недоступно через опубликованный порт?
- Как правильно организовать persistency данных?
- Почему сборка через BuildKit ведёт себя иначе?
Для содержательного ответа укажите версию Docker, операционную систему, минимальный Dockerfile или Compose-конфигурацию и фактическую ошибку.
Если вопрос касается поведения конкретного продукта Docker и требует подробного воспроизведения, можно дополнительно использовать Docker Community Forums.
Terraform RU — сообщество Infrastructure as Code
Ссылка: t.me/terraform_ru
Русскоязычная группа для вопросов по Terraform.
Типичные темы:
- Управление state-файлами.
- Организация Terraform-модулей.
- Проблемы с провайдерами.
- Ошибки при
terraform planиterraform apply. - Блокировка state.
- Импорт существующих ресурсов.
- Управление инфраструктурой в разных окружениях.
Важное отличие от общих DevOps-вопросов: ошибка может находиться не в Terraform как инструменте, а в API облачного провайдера.
Поэтому перед публикацией полезно определить, что именно возвращает ошибку: Terraform Core, provider или внешняя платформа.
Не публикуйте Terraform state целиком. Он может содержать пароли, токены и другие чувствительные данные даже тогда, когда переменные помечены как sensitive.
Официальные сообщества: Kubernetes, Docker, Terraform и CI/CD
Для сложных технических вопросов полезно иметь доступ не только к русскоязычным группам, но и к площадкам, связанным с разработчиками инструментов.
Kubernetes Discuss и Kubernetes Slack
Kubernetes Discuss — форум для технических обсуждений Kubernetes.
Он удобен, если требуется описать воспроизводимую ошибку, приложить конфигурацию и сохранить историю диагностики.
Kubernetes Slack — рабочее пространство международного сообщества Kubernetes. На официальном сайте проекта указано, что в нём существуют многочисленные тематические каналы, а вступление выполняется через специальную форму приглашения.
В отличие от общего DevOps-чата, здесь можно найти обсуждения отдельных компонентов экосистемы и направлений работы проекта.
Это особенно полезно при вопросах по Kubernetes API, контроллерам, сетям, хранилищам и разработке расширений.
Docker Community Forums
Ссылка: forums.docker.com
Официальный форум сообщества Docker подходит для нетривиальных ошибок Docker Desktop, Docker Engine, контейнерных сетей и других компонентов экосистемы.
Здесь удобно публиковать структурированные сообщения с техническим контекстом.
Если подозреваете баг, сначала найдите похожие темы и проверьте, не существует ли уже известного решения или обходного пути.
HashiCorp Discuss
Ссылка: discuss.hashicorp.com
Официальный форум сообщества HashiCorp, включающий разделы Terraform, Vault, Consul, Nomad и других продуктов.
Подойдёт для вопросов, связанных с Infrastructure as Code, секретами, политиками доступа и эксплуатацией инфраструктурных сервисов.
Если вы используете OpenTofu, дополнительно проверяйте документацию и обсуждения именно этого проекта: несмотря на общее происхождение, дальнейшие изменения могут различаться.
GitLab Forum и GitHub Community
Для проблем с пайплайнами GitLab используйте GitLab Forum и документацию по отладке CI/CD.
При работе с GitHub Actions пригодится GitHub Community Discussions.
Здесь можно разбирать ошибки runner, permissions, caching, артефактов и конфигурации workflow.
Если проблема связана с конкретным action, плагином или инструментом, лучше также проверить Issues его собственного репозитория.
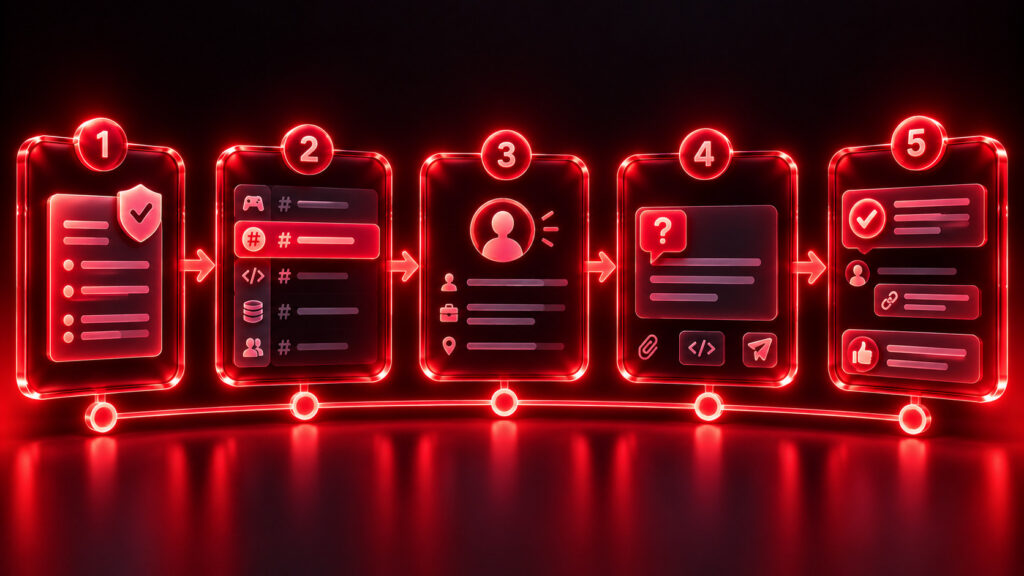
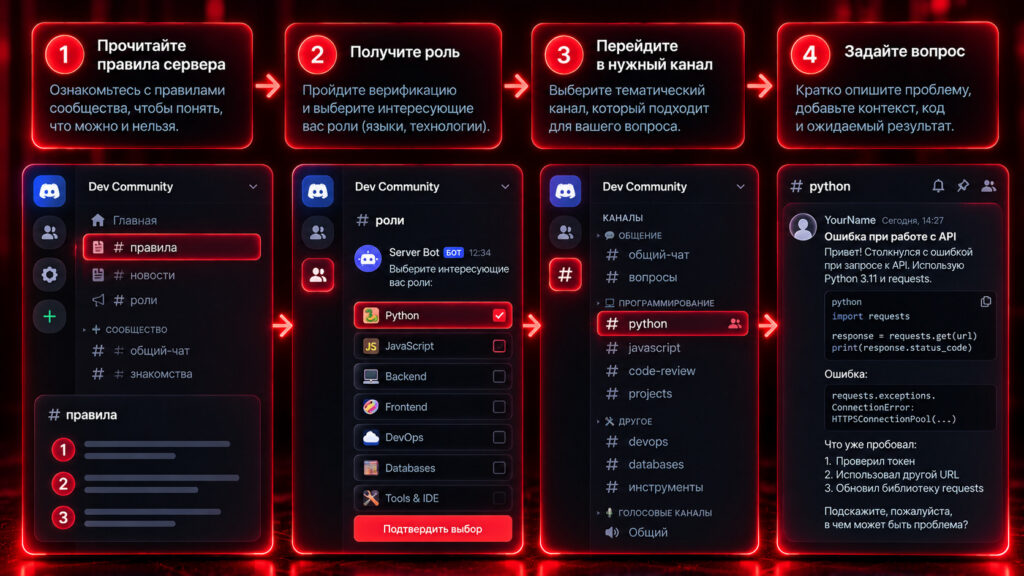
Telegram, Slack, Discord или форум: какой формат выбрать
Формат профессионального сообщества влияет на то, насколько удобно получать помощь и возвращаться к ранее найденным решениям.
| Формат | Сильная сторона | Ограничение | Когда использовать |
|---|---|---|---|
| Telegram | Оперативное общение на русском языке | Длинные обсуждения теряются в потоке | Короткий вопрос, проверка гипотезы |
| Slack | Тематические каналы внутри технической экосистемы | Не везде доступна полная история сообщений | Общение с сообществом конкретного проекта |
| Discord | Тематические каналы, ветки, голосовое общение | Качество зависит от организации конкретного сервера | Совместная работа и обсуждение инструмента |
| Форумы и Q&A | Подробные воспроизводимые решения | Нет гарантии быстрого ответа | Сложные ошибки и архитектура |
| GitHub Issues | Контакт с разработчиками конкретного проекта | Нужен подтверждённый или обоснованно предполагаемый дефект | Баги, регрессии, несовместимости |
В исходном выборе важно учитывать ещё одну деталь: официальное сообщество проекта не обязательно находится в Discord. Некоторые инструменты используют Slack, другие — GitHub Discussions, Discourse или собственные форумы.
Поэтому актуальную ссылку на официальный чат лучше брать с сайта проекта или из его репозитория, а не из случайных подборок серверов.
Где искать помощь: маршрутизатор DevOps-проблем
Иногда инженер понимает симптом, но не знает, какое сообщество выбрать.
В таком случае сначала определите слой, на котором проявляется проблема.
| Симптом | Первые проверки | Куда обращаться |
|---|---|---|
Pod находится в Pending | Events, ресурсы, node selectors, taints | Kubernetes |
Pod уходит в CrashLoopBackOff | Логи предыдущего контейнера, exit code, probes | Kubernetes или сообщество приложения |
| Container image не собирается | Dockerfile, build context, вывод BuildKit | Docker |
| Не проходит Terraform Apply | Ошибка provider, версия, права и квоты облака | Terraform, HashiCorp Discuss |
| Падает GitLab Runner | Job logs, executor, сетевой доступ, права | GitLab Forum |
| Не работает DNS внутри кластера | CoreDNS, Service, NetworkPolicy, upstream DNS | Kubernetes / Network Engineering |
| Растёт latency сервиса | Метрики, трассировки, зависимые сервисы | SRE, Observability |
| Проблема с IAM или квотами | Policies, cloud API, ограничения аккаунта | Поддержка облака или профильное сообщество |
Эта таблица помогает выбрать первую площадку, но не определяет причину автоматически.
Например, CrashLoopBackOff — не диагноз, а состояние, указывающее на повторяющиеся сбои контейнера. Причиной может быть ошибка приложения, некорректная конфигурация, отсутствие зависимости или проблема с ресурсами.
Поэтому хороший вопрос начинается с диагностики, а не с предположения о виноватом компоненте.
Практический сценарий: Pod в Kubernetes постоянно перезапускается
Рассмотрим типичную ситуацию: после деплоя приложение перестало работать, а Kubernetes показывает CrashLoopBackOff.
Не стоит сразу публиковать весь Deployment и просить «посмотреть конфиг».
Вначале выполните несколько базовых проверок.
1. Проверьте состояние Pod и события.
kubectl describe pod POD_NAME -n NAMESPACEПосмотрите причину завершения контейнера, количество перезапусков и события.
2. Изучите логи предыдущего запуска контейнера.
kubectl logs POD_NAME -n NAMESPACE \
  -c CONTAINER_NAME --previous
Флаг --previous позволяет получить логи предыдущего экземпляра контейнера, если они ещё доступны.
3. Проверьте конфигурацию приложения.
Уточните, доступны ли обязательные зависимости, корректны ли переменные окружения, настройки портов, probes и лимиты ресурсов.
4. Сопоставьте проблему с последним изменением.
Определите, появился ли сбой после смены образа, конфигурации, Secret, ConfigMap или настроек Deployment.
5. Сформулируйте проверяемую гипотезу.
Например: «После обновления образа приложение завершается с кодом 1. В предыдущем релизе с теми же ресурсами проблема не воспроизводилась. Из логов видно, что процесс падает на инициализации подключения к БД».
С таким описанием можно обращаться в профильный Kubernetes-чат.
Если же логи однозначно указывают на внутреннюю ошибку приложения, сначала имеет смысл подключить его разработчиков.
Как задать технический вопрос в DevOps-чате
Одна из главных причин непродуктивных обсуждений — отсутствие исходных данных.
Сообщение «После обновления не работает Ingress» почти не помогает определить причину.
Вместо него используйте короткий шаблон.
Шаблон обращения
Тема: что именно перестало работать.
Окружение:
- Инструмент и точная версия.
- Операционная система и среда запуска.
- Облачный провайдер или self-hosted.
- Связанные компоненты и версии.
Ожидаемый результат: что должно происходить.
Фактический результат: наблюдаемая ошибка.
Когда возникла проблема: после какого действия или изменения.
Что уже проверено: результаты диагностики.
Минимальный пример: обезличенный конфиг, необходимые логи или команды.
Конкретный вопрос: какую гипотезу требуется проверить или в каком компоненте искать причину.
Пример корректного вопроса
Условный пример, не описание подтверждённого дефекта конкретных версий.
Kubernetes, кластер с Cilium и CoreDNS.
После изменения сетевой конфигурации приложения в одном namespace перестали разрешать внешние DNS-имена. Внутренние сервисы Kubernetes по-прежнему разрешаются.
Проверили состояние CoreDNS, доступность upstream DNS с узлов и NetworkPolicy в проблемном namespace.
Сбой воспроизводится только у части Pod. Изменение конфигурации DNS внутри приложения не устраняет проблему.
Подскажите, какие показатели Cilium и сетевой маршрутизации помогут локализовать причину? Обезличенные результаты проверок прилагаю.
Вопрос содержит конкретную проблему и результаты уже выполненных действий.
Участникам не нужно начинать с уточнений о том, что именно не работает.
Как безопасно делиться логами, конфигурациями и манифестами
Работа DevOps-инженера часто связана с доступом к критически важной инфраструктуре.
Поэтому публикация неочищенных конфигураций в публичном чате может представлять серьёзный риск.
Особенно внимательно следует относиться к Kubernetes Secret, Terraform state, файлам .env, конфигурациям CI/CD и журналам аутентификации.
| Что публикуете | Основной риск | Безопасный вариант |
|---|---|---|
| Kubernetes YAML | Токены, внутренние адреса и имена сервисов | Минимальный обезличенный манифест |
| Kubernetes Secret | Раскрытие ключей и паролей | Только структура и названия полей, без значений |
| Terraform state | Пароли, атрибуты ресурсов, инфраструктурные данные | Обезличенный фрагмент конфигурации, не полный state |
| CI/CD logs | CI-токены, секреты и внутренние URL | Очищенный фрагмент ошибки |
| Сетевая схема | Раскрытие внутренней топологии | Условная схема с заменёнными адресами |
| Cloud IAM policy | Детали инфраструктуры и идентификаторы | Минимальный пример на тестовых ресурсах |
Важно: Base64 — это кодирование, а не шифрование. Значения в поле data объекта Kubernetes Secret не становятся безопасными для публичной публикации.
Официальная документация Kubernetes отдельно предупреждает о необходимости защищать манифесты Secret: Good practices for Kubernetes Secrets.
Также не следует полагаться только на атрибут sensitive в Terraform. Он скрывает значения в некоторых видах вывода, но сам по себе не гарантирует их отсутствия в state.
Подробнее: HashiCorp — Manage sensitive data.
Что делать, если секрет уже опубликован
Не ограничивайтесь удалением сообщения.
Скомпрометированный токен необходимо отозвать или перевыпустить, обновить его в соответствующих системах и проверить журналы доступа на признаки несанкционированного использования.
Если произошла утечка рабочих учётных данных, действуйте по принятой в организации процедуре реагирования на инциденты.
Когда DevOps-чат не должен быть основным инструментом
Профессиональное сообщество полезно для поиска гипотез, но есть ситуации, когда обращение в публичный чат — не первый шаг.
Критичный production-инцидент. Если сервис недоступен и затронуты пользователи, необходимо использовать внутреннюю процедуру реагирования, систему дежурств и эскалации.
Подозрение на компрометацию инфраструктуры. Не стоит публиковать конфиденциальные журналы или сведения об уязвимостях. Подключите ответственных за информационную безопасность.
Действия с необратимыми последствиями. Изменения production-state, прав доступа, сетевой конфигурации или хранилищ требуют проверенного плана действий и возможности восстановления.
Проблема управляемого облачного сервиса. При подтверждённом сбое на стороне провайдера более подходящим каналом может быть его техническая поддержка.
Совет незнакомого участника чата не должен становиться единственным основанием для изменения рабочей инфраструктуры.
SRE и Platform Engineering: сообщества для более узких задач
По мере профессионального развития специализация инженера становится важнее общего названия DevOps.
Сообщества SRE
SRE-инженеры концентрируются на надёжности сервисов, измеримых показателях доступности, управлении инцидентами, SLO и снижении операционной нагрузки.
Полезные направления поиска:
- Reddit r/sre — обсуждение инженерных практик надёжности.
- Google SRE — официальные руководства и практические материалы.
- Сообщества Prometheus, Grafana, OpenTelemetry и других инструментов наблюдаемости.
Для SRE важно не только устранить конкретный сбой, но и понять, как уменьшить вероятность его повторения.
Как правильно разбирать инциденты
В руководстве Google сформулирован важный принцип:
«Один из основополагающих принципов культуры SRE — разбор инцидентов без поиска виноватых».
руководство Google по управлению инцидентами
Перевод положения из официального руководства Google SRE.
Практический смысл заключается в том, что после инцидента команда должна исследовать причины, оценить эффективность реагирования и определить меры, снижающие будущие риски.
Поэтому профессиональные сообщества полезны не только как источник готовых команд, но и как пространство для обсуждения инженерных решений.
Если вы публикуете обезличенный разбор инцидента, полезно включить хронологию, влияние на пользователей, обнаруженные причины и меры предотвращения.
Сообщества Platform Engineering
Платформенные инженеры занимаются внутренними платформами разработки, стандартизированными путями деплоя, автоматизацией инфраструктуры и Developer Experience.
В этой области востребованы обсуждения Backstage, Crossplane, GitOps, self-service окружений и архитектуры внутренних платформ.
Здесь особенно полезны официальные сообщества инструментов CNCF и тематические форумы, поскольку многие задачи требуют обсуждения архитектурных компромиссов, а не поиска единственной правильной команды.
Сообщества для начинающих DevOps-инженеров
Junior-специалистам стоит сочетать профильные чаты с образовательными и Q&A-площадками.
Для базовых вопросов по Linux, системным сервисам, сетям и контейнерам можно использовать:
- Хабр Q&A — русскоязычные технические вопросы.
- Linux.org.ru — обсуждения Linux и системного администрирования.
- Docker Community — материалы и сообщества Docker.
Полезно постепенно переходить от вопросов «какую команду использовать» к вопросам «почему система ведёт себя именно так».
Это развивает навыки диагностики, необходимые инженеру эксплуатации.
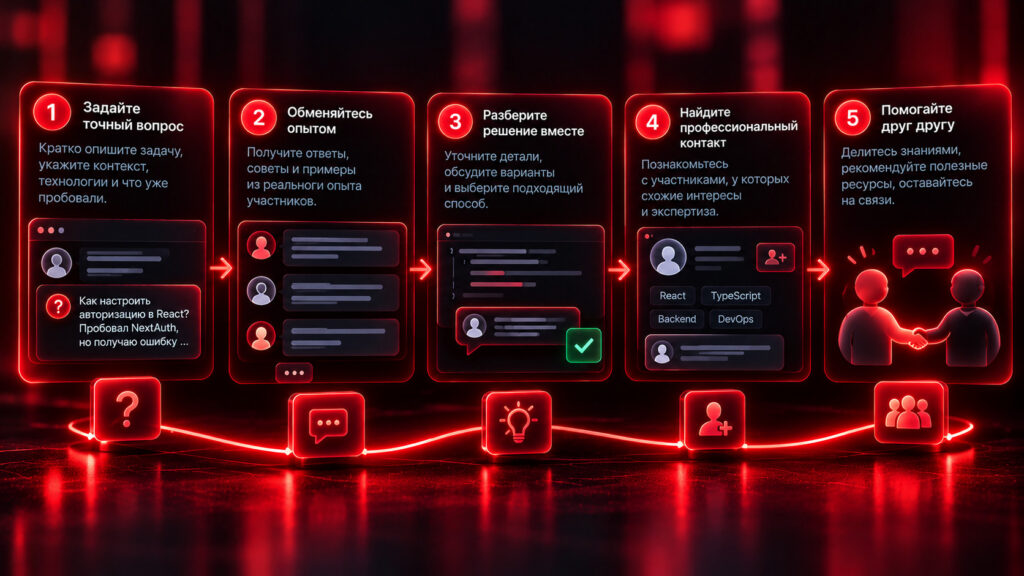
Как оценить качество DevOps-сообщества до вступления
Для практической оценки достаточно просмотреть правила и несколько десятков недавних сообщений.
Обратите внимание на следующие признаки:
- Предметные ответы. Участники объясняют причины, приводят команды диагностики и ссылки на документацию.
- Соответствие специализации. Обсуждаются технологии, которые действительно используются в вашей работе.
- Актуальность. Есть содержательные технические диалоги, а не только объявления.
- Модерация. Спам и подозрительные предложения оперативно ограничиваются.
- Культура общения. Участники уточняют контекст и помогают локализовать проблему, а не высмеивают начинающих.
Отдельный критерий — отношение к безопасности.
Если в сообществе регулярно просят предоставить production-доступ или предлагают небезопасные действия без объяснения последствий, использовать его рекомендации нужно с особой осторожностью.
Оптимальная комбинация: один общий DevOps-чат для обмена опытом, один специализированный по основному инструменту и официальная документация с форумом проекта.
Частые вопросы о DevOps-чатах и сообществах
Где найти русскоязычный DevOps-чат в Telegram?
Начните с t.me/devops_ru. Это общая группа для обсуждения DevOps, облаков, мониторинга и инфраструктуры. Если интересует конкретный инструмент, лучше выбрать профильное сообщество.
Есть ли отдельный Telegram-чат по Kubernetes?
Да, существует Kubernetes RU. Для более сложных вопросов доступны также Kubernetes Discuss и официальное Slack-сообщество проекта.
Где обсуждать Terraform и Infrastructure as Code?
Русскоязычные вопросы можно задавать в Terraform RU. Для подробного разбора проблем Terraform и экосистемы HashiCorp подходит HashiCorp Discuss.
Где искать DevOps-сообщества в Discord?
Лучше начинать с сайтов конкретных open-source проектов и проверять их официальные ссылки на Discord. Не все сообщества используют эту платформу: Kubernetes, например, развивает официальное пространство в Slack.
Где задать вопрос по GitLab CI/CD?
Используйте GitLab Forum и документацию по диагностике пайплайнов. Если проблема связана с конкретным сторонним инструментом, проверьте также его репозиторий и Issues.
Можно ли найти работу через DevOps-чаты?
Некоторые сообщества допускают вакансии, но в технических группах они могут быть запрещены. Для поиска работы существуют специализированные площадки, например @devops_jobs.
Что делать, если никто не отвечает на вопрос?
Проверьте, достаточно ли конкретно описана проблема. Добавьте версии компонентов, точную ошибку и результаты диагностики. Если проблема узкая, перенесите её в соответствующее тематическое сообщество или форум.
Стоит ли доверять советам из DevOps-чатов?
Любую рекомендацию необходимо проверять с учётом версии инструмента, архитектуры системы и возможных последствий. Особенно это касается изменений производственной инфраструктуры, политик безопасности и конфигураций хранилищ.
Вывод: выбирайте DevOps-сообщество под задачу, а не по популярности
Хорошее сообщество DevOps-инженеров помогает не только быстрее находить решения, но и развивать инженерное мышление, знакомиться с альтернативными подходами и учиться на опыте коллег.
Для общих вопросов подойдут крупные Telegram-группы. Для проблем Kubernetes, Docker или Terraform лучше использовать профильные сообщества. Если требуется глубокий технический разбор, начните с официальной документации и тематических форумов.
Не менее важно правильно оформлять запросы: точные версии компонентов, минимальный воспроизводимый пример и очищенные от секретов диагностические данные существенно повышают ценность общения.
Если вам нужны дополнительные сообщества по Linux, сетям, системному администрированию, backend-разработке или смежным IT-направлениям, воспользуйтесь разделом IT-чатов CommyX. Для более широкого поиска тематических групп доступен каталог Telegram-чатов.