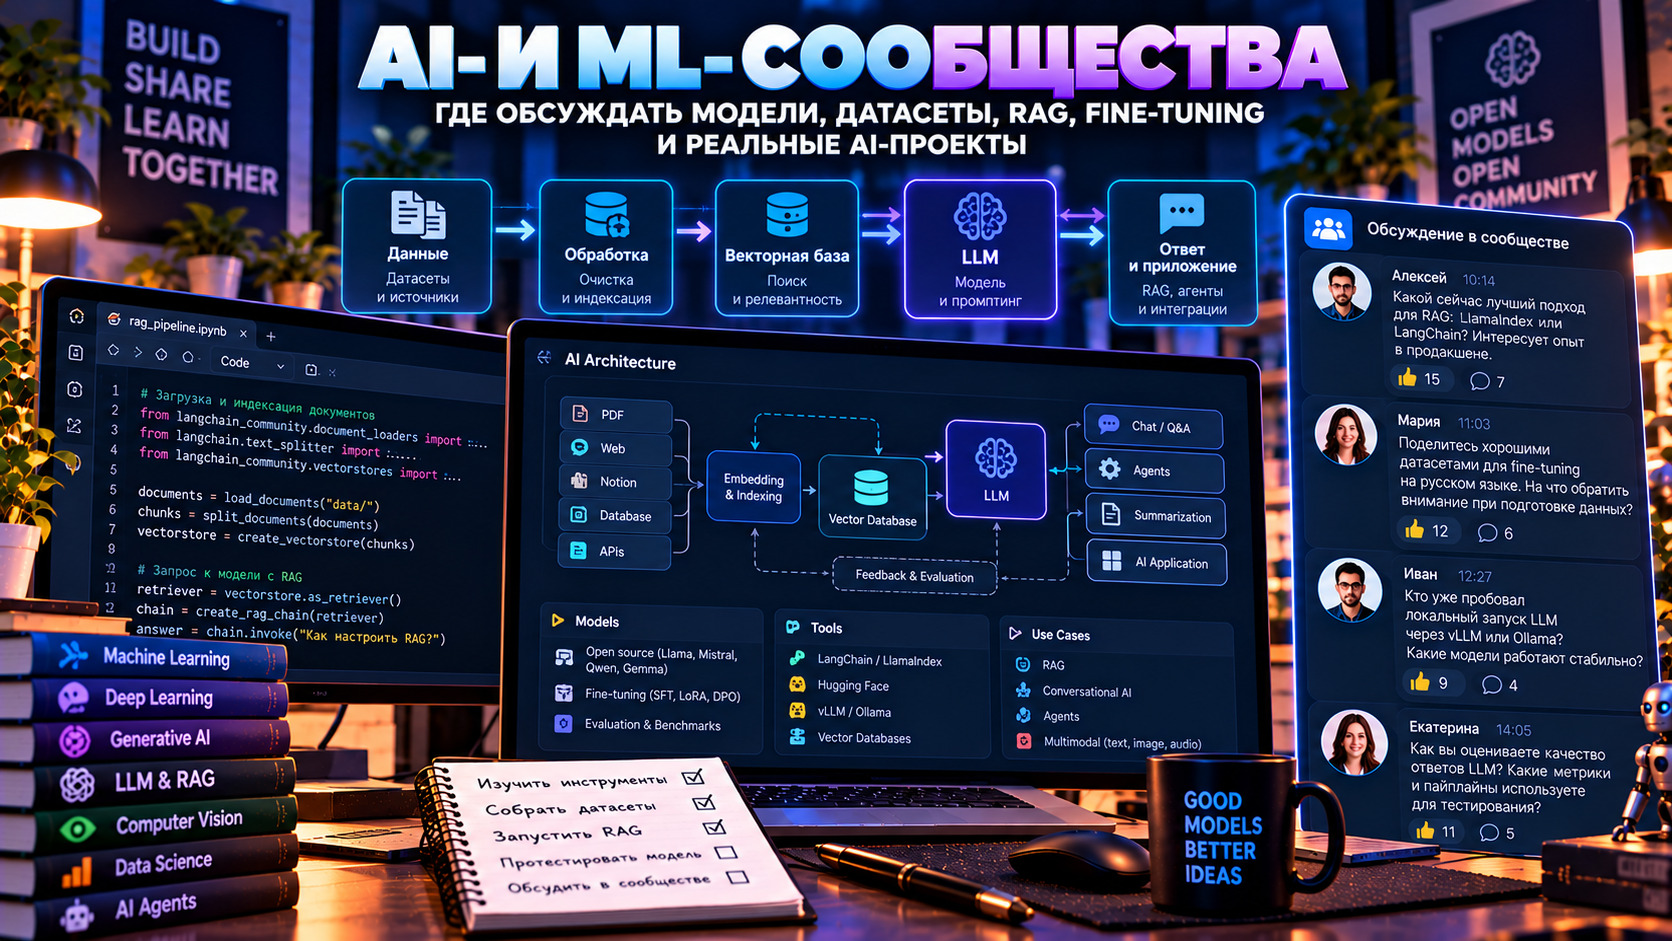
Сообщества разработчиков искусственного интеллекта помогают решать проблемы с обучением нейросетей, запуском LLM, построением RAG-систем и оптимизацией инференса. Но универсального чата, в котором одинаково глубоко разбираются в PyTorch, квантовании моделей, MLOps и архитектуре AI-агентов, практически не существует.
Для русскоязычного общения можно начать с Open Data Science, Machine Learning Chat или Natural Language Processing. Если проблема связана с конкретным инструментом, полезнее использовать официальные площадки: Hugging Face Forums, PyTorch Forums или vLLM Forum.
Выбор зависит от задачи. Ошибку CUDA лучше обсуждать с разработчиками соответствующего фреймворка, качество RAG — со специалистами по поиску и LLM, а методологию эксперимента — в исследовательском ML-сообществе.
В статье собраны конкретные чаты, форумы и профессиональные группы, а также практические рекомендации: куда обращаться с разными проблемами, какие данные подготовить и как получить технический ответ без раскрытия рабочих материалов.
Где общаются AI- и ML-разработчики: быстрый выбор сообщества
Если вы уже знаете, какая технология вызывает затруднения, используйте таблицу.
| Направление | Сообщество | С какими вопросами обращаться |
|---|---|---|
| Машинное обучение и нейросети | Machine Learning Chat | ML-алгоритмы, Python, обучение моделей, обмен опытом |
| Русскоязычное ML-сообщество | ODS.ai, ODS Mattermost | ML, исследования, обучение, профессиональные проекты |
| NLP, языковые модели | Natural Language Processing | NLP, обработка текста, языковые модели |
| Исследования и Deep Learning | AbstractDL Chat | Архитектуры нейросетей, научные работы, CV и NLP |
| Вопросы ML-сообществу Яндекса | Yandex for ML Chat | ML-практика, обучение, исследования |
| Hugging Face, Transformers, Datasets | Hugging Face Forums | Модели, токенизаторы, fine-tuning, ошибки библиотек |
| PyTorch, GPU и обучение моделей | PyTorch Forums | Autograd, CUDA, распределённое обучение, оптимизация |
| vLLM, серверный инференс | vLLM Forum | Производительность, память GPU, запуск и обслуживание LLM |
| llama.cpp и локальные модели | llama.cpp Discussions | GGUF, CPU/GPU-инференс, совместимость оборудования |
| MLOps и инженерия моделей | DataTalks.Club, ML/MLOps Selectel | Пайплайны, деплой, инфраструктура, жизненный цикл моделей |
Ссылки подтверждены по публичным страницам сообществ и официальным ресурсам проектов. Правила участия, активность и доступность приглашений могут меняться.
Короткое правило: если не работает конкретная библиотека — начните с сообщества её разработчиков. Если технически всё работает, но качество модели неудовлетворительное, ищите группу по ML-методологии или прикладной области.
Русскоязычные Telegram-чаты по искусственному интеллекту
Telegram удобен для обсуждения инженерных подходов, обмена опытом и коротких технических вопросов.
Но важно различать три формата: профессиональный групповой чат, тематический канал с комментариями и сообщество вокруг образовательного проекта.
Новостной канал помогает следить за исследованиями, однако не обязательно подходит для отладки кода.
Machine Learning Chat — общие вопросы по ML
Ссылка: t.me/machinee_learning
Русскоязычный Telegram-чат для обсуждения машинного обучения.
Подходит специалистам, которые работают с классическими ML-моделями, Python, нейросетями и исследовательскими задачами.
Здесь уместны вопросы о:
- Выборе алгоритма под тип данных.
- Подготовке признаков и датасетов.
- Переобучении модели.
- Валидации и метриках качества.
- Работе с Python-библиотеками.
- Типичных ошибках обучения.
Например, если качество модели резко выросло после добавления нового признака, полезно обсудить, не содержит ли этот признак информацию, которая в реальном сценарии предсказания будет недоступна.
Это пример возможной утечки целевой информации — target leakage.
При обращении лучше описывать структуру задачи и способ валидации, а не просто прикладывать значение accuracy.
Natural Language Processing — NLP и языковые модели
Ссылка: t.me/natural_language_processing
Русскоязычное сообщество по обработке естественного языка. В описании группы указаны технические вопросы, новости, мероприятия и вакансии.
Площадка подходит для обсуждения:
- Классификации и извлечения информации из текста.
- Обучения и адаптации языковых моделей.
- Эмбеддингов и семантического поиска.
- Обработки текстов на разных языках.
- Оценки качества NLP-моделей.
- Подготовки текстовых датасетов.
Например, здесь можно обсудить, почему классификатор показывает хорошие результаты на случайном разделении датасета, но хуже работает на новых документах.
Возможно, проблема связана с временным сдвигом данных, дубликатами или различиями между обучающей и реальной выборкой.
Для вопроса о конкретном исключении в библиотеке Transformers дополнительно стоит использовать форум Hugging Face.
AbstractDL Chat — обсуждение исследований и Deep Learning
Ссылка: t.me/abstractdl_chat
Чат, связанный с Telegram-каналом AbstractDL, посвящённым компьютерному зрению, NLP и искусственному интеллекту.
Это подходящее направление для специалистов, которым интересны архитектуры нейросетей, исследования и технические особенности современных моделей.
Здесь особенно полезно обсуждать не только итоговые результаты, но и подходы к экспериментам:
- Какие предположения лежат в основе метода?
- Как авторы сравнивают модель с baseline?
- Насколько корректна схема валидации?
- Какие вычислительные ресурсы потребовались?
- Можно ли воспроизвести результат?
Если вы хотите обсудить научную статью, подготовьте ссылку на оригинальную публикацию и конкретный вопрос по методу или эксперименту.
Сообщение «что думаете об этой модели?» обычно даёт менее содержательную дискуссию, чем просьба проверить определённое техническое утверждение.
Yandex for ML Chat — обучение и профессиональные обсуждения
Чат: Yandex for ML Chat
Канал: @yandexforml
Официальный канал Yandex for ML связан с отдельной группой для общения и вопросов участников сообщества.
Канал публикует материалы об анализе данных, исследованиях, мероприятиях и образовательных возможностях.
Чат можно использовать для общения с другими специалистами и обсуждения вопросов, относящихся к тематике сообщества.
Однако не стоит рассматривать любую подобную группу как канал официальной технической поддержки библиотек или продуктов Яндекса.
Если ошибка возникает в конкретном инструменте, сначала изучите его документацию и специализированный issue tracker.
Open Data Science — крупная профессиональная экосистема
Сайт: ods.ai
Вход в сообщество: ODS Mattermost
Open Data Science (ODS) — русскоязычная профессиональная экосистема специалистов по машинному обучению, Data Science и смежным направлениям.
Важное отличие от обычного Telegram-чата — сочетание профессионального общения, образовательных материалов и проектов.
На сайте ODS есть отдельный трек для подключения к Mattermost с инструкциями и описанием каналов.
В сообществе можно обсуждать ML-исследования, методы обучения, NLP, компьютерное зрение, MLOps и карьерные вопросы.
ODS особенно полезно тем, кто хочет не только исправить ошибку, но и развиваться в определённом направлении машинного обучения.
Например, начинающему ML-инженеру имеет смысл изучать образовательные треки и обсуждения экспериментов, а опытному специалисту — искать профессиональные дискуссии по своей области.
Где обсуждать LLM, RAG и AI-агентов
Разработка приложений на базе больших языковых моделей отличается от классического ML.
Проблема может находиться не в самой модели, а в поисковом индексе, подготовке документов, серверном инференсе или логике приложения.
Поэтому для LLM-разработчика важно различать несколько направлений.
RAG и семантический поиск
RAG (Retrieval-Augmented Generation) объединяет поиск информации и генерацию ответа моделью.
Типичные вопросы:
- Как организовать поиск по документам?
- Почему нужный документ не попадает в контекст?
- Как выбирать размер чанков?
- Нужен ли reranker?
- Как оценивать качество поиска?
- Как уменьшить количество неподтверждённых утверждений?
Для обсуждения архитектуры полезны сообщества NLP и LLM-разработчиков, а для ошибок конкретного инструмента — его официальные каналы.
Например, если проблема возникает внутри LangChain или LlamaIndex, первым шагом может быть поиск по Issues и Discussions соответствующего репозитория.
Но если все библиотеки работают корректно, а система находит нерелевантные документы, нужен разговор о качестве retrieval, а не об ошибках Python.
AI-агенты
В агентных системах трудности часто возникают из-за управления состоянием, последовательности вызовов инструментов и проверки результата действий.
При обсуждении такого проекта полезно показать:
- Цель агента.
- Доступные инструменты.
- Правила выполнения действий.
- Ограничения доступа.
- Способ проверки результата.
- Условия остановки сценария.
Особенно важно отделять ошибку генерации текста от ошибки выполнения действия.
Если агент отвечает «задача выполнена», но фактического результата нет, необходимо исследовать журнал вызовов инструментов и критерии успешности.
Такие вопросы могут потребовать совместной экспертизы LLM-разработчиков и backend-инженеров.
Форумы Hugging Face, PyTorch и vLLM: когда лучше обращаться к разработчикам инструментов
Для сложных проблем с конкретными библиотеками официальные форумы обычно полезнее универсальных AI-чатов.
Hugging Face Forums
Ссылка: discuss.huggingface.co
Форум Hugging Face содержит отдельные категории для начинающих, исследователей и пользователей различных библиотек.
Среди них Transformers, Datasets, Tokenizers, Accelerate и Diffusers.
Здесь удобно обсуждать:
- Загрузку и использование моделей.
- Fine-tuning.
- Совместимость токенизаторов.
- Подготовку датасетов.
- Проблемы с моделями Hugging Face Hub.
- Ошибки библиотек.
- Вопросы воспроизводимости.
Если ошибка связана с конкретной моделью, укажите её полный идентификатор, ревизию и версию используемой библиотеки.
Это намного полезнее формулировки «модель с Hugging Face не запускается».
PyTorch Forums
Ссылка: discuss.pytorch.org
Официальный форум PyTorch посвящён коду, установке, исследованиям и техническим проблемам фреймворка.
На площадке есть обсуждения компьютерного зрения, NLP, компиляции, распределённого обучения и C++ API.
Сюда стоит обращаться при проблемах с:
- Вычислением градиентов.
- Работой Autograd.
- CUDA и совместимостью оборудования.
torch.compile.- DDP и FSDP.
- Оптимизацией памяти.
- Численной точностью.
Перед вопросом о CUDA Out of Memory полезно собрать информацию о версии PyTorch, GPU, объёме памяти, batch size и режиме обучения.
Отдельно проверьте, действительно ли память занята параметрами модели или проблема связана с активациями, оптимизатором либо накоплением тензоров в коде.
vLLM Forum — серверный инференс LLM
Ссылка: discuss.vllm.ai
Slack: slack.vllm.ai
vLLM — движок для обслуживания языковых моделей, ориентированный на эффективное использование вычислительных ресурсов.
На официальном форуме предусмотрены разделы по совместимости моделей, оборудованию, бенчмаркам и возможностям инструмента.
Сюда имеет смысл обращаться, если:
- Модель не запускается на выбранном GPU.
- Возникает ошибка при загрузке весов.
- Неожиданно растёт потребление видеопамяти.
- Падает производительность при параллельных запросах.
- Проблема появляется после обновления движка.
- Требуется корректно сравнить параметры serving.
Важное различие: низкая скорость генерации не обязательно означает ошибку vLLM. На результат влияют длина запросов, concurrency, batching, модель, оборудование и конфигурация обслуживания.
Для сравнений нужно фиксировать условия нагрузки, а не только число токенов в секунду.
llama.cpp и локальные языковые модели
Ссылка: llama.cpp Discussions
Площадка подходит для обсуждения запуска языковых моделей локально, формата GGUF, производительности CPU/GPU и различных аппаратных бэкендов.
Полезно указывать точный файл модели, конфигурацию квантования, устройство, объём оперативной и видеопамяти, а также команду запуска.
Не следует смешивать разные форматы квантования в одной рекомендации без проверки поддержки конкретным движком.
Например, файл GGUF, подготовленный для llama.cpp, не обязательно можно использовать тем же способом в другом сервере инференса.
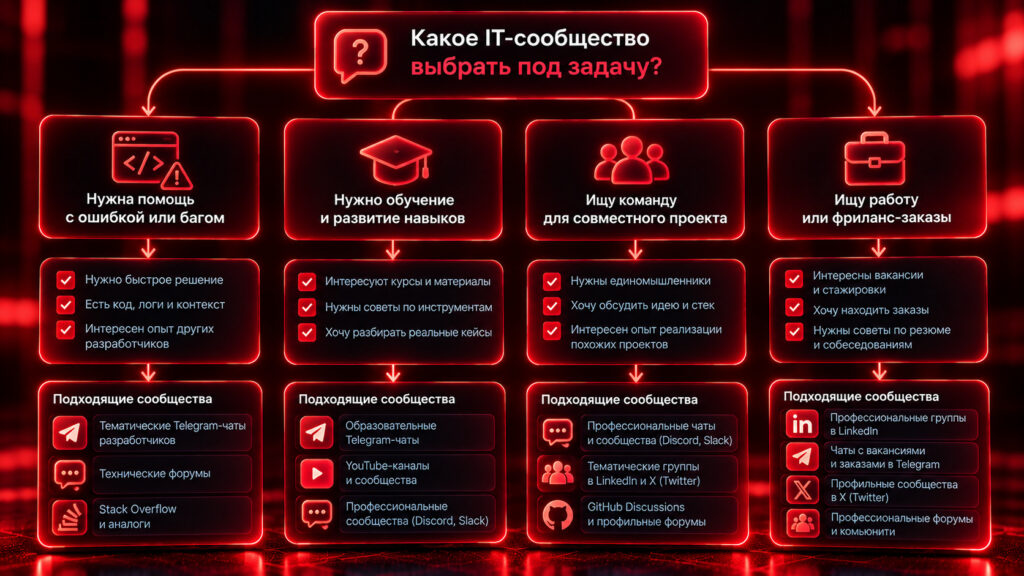
Как выбрать сообщество по симптомам проблемы
Перед публикацией вопроса важно локализовать неисправность хотя бы до одного компонента.
| Симптом | Что проверить первым | Куда обращаться |
|---|---|---|
| Модель выдаёт неправильные ответы по документам | Retrieval, контекст, промпт, тестовые примеры | NLP, RAG/LLM-сообщества |
| Модель не помещается в VRAM | Веса, точность, KV-cache, batch, длину контекста | vLLM, llama.cpp, PyTorch |
| Обучение нестабильно | Loss, learning rate, данные, градиенты | PyTorch, ML-сообщества |
| Результаты эксперимента не воспроизводятся | Seed, версии, данные, недетерминированные операции | PyTorch, исследовательские форумы |
| После обновления библиотеки появился баг | Changelog, версии зависимостей, Issues | GitHub конкретного проекта |
| При нагрузке выросла задержка ответа | TTFT, время генерации, concurrency, batching | vLLM, MLOps |
| Fine-tuning ухудшил качество модели | Dataset, baseline, validation, гиперпараметры | Hugging Face, ODS |
| ML-сервис работает локально, но падает в production | Окружение, логи, зависимости, ресурсы | MLOps и инфраструктурные сообщества |
Это ориентир для выбора первой площадки, а не автоматическая диагностика.
Если причина пока неизвестна, лучше начать с воспроизводимого примера и результатов нескольких проверок.
Практический сценарий: RAG находит документы, но отвечает неправильно
Рассмотрим типичную проблему разработки AI-приложения.
Ситуация: компания создала помощника для ответов по внутренней базе знаний. Поиск возвращает документы, однако ответы иногда содержат неверные сведения.
Первое желание — заменить языковую модель на более мощную. Но проблема может находиться совсем в другом компоненте.
Шаг 1. Проверить, найден ли нужный документ
Для нескольких заранее подготовленных вопросов сравните результаты retrieval с ожидаемыми источниками.
Если правильного документа нет среди найденных, проблема возникает до генерации ответа.
В этом случае исследуйте качество эмбеддингов, сегментацию документов, поисковый индекс, фильтрацию и ранжирование.
Шаг 2. Проверить, дошёл ли нужный фрагмент до LLM
Даже если документ найден, он может не попасть в окончательный контекст из-за ограничений на количество фрагментов или длину сообщения.
Также возможно, что нужный текст был разрезан на части и потерял смысл.
Шаг 3. Проверить сам ответ модели
Если корректный источник присутствует в контексте, но модель отвечает неправильно, исследуйте инструкцию, формат ответа и поведение модели.
Отдельно проверьте, способна ли система сообщать об отсутствии информации, вместо того чтобы придумывать ответ.
Шаг 4. Сравнить результаты на контрольных примерах
Составьте небольшой набор вопросов с заранее известными правильными ответами и источниками.
Оцените поиск и генерацию отдельно.
| Наблюдение | Возможная область проблемы | Что обсудить |
|---|---|---|
| Нужный источник не найден | Retrieval | Эмбеддинги, фильтры, ранжирование |
| Источник найден, но не попал в контекст | Сборка контекста | Top-k, ограничения длины, чанкинг |
| Источник есть, но ответ неверный | Генерация | Промпт, модель, формат вывода |
| Ответ верен, но ссылки на источники неверные | Атрибуция | Соответствие утверждений и документов |
| Ответ качественный, но слишком медленный | Производительность | Задержка поиска, reranking, инференс |
Главный вывод: прежде чем спрашивать «какую LLM выбрать для RAG», определите, какой компонент действительно ограничивает качество.
Такой подход делает обсуждение в профессиональном сообществе значительно продуктивнее.
Как обсуждать обучение моделей и воспроизводимость экспериментов
В ML-сообществах недостаточно сообщить, что новая архитектура дала более высокий результат.
Для полноценного обсуждения важно понимать условия эксперимента.
Например, при сравнении двух моделей нужно зафиксировать:
- Датасет и способ разделения на выборки.
- Метрику и правила её расчёта.
- Версии библиотек.
- Гиперпараметры.
- Seed и источники случайности.
- Вычислительное окружение.
- Baseline для сравнения.
При этом один и тот же seed не гарантирует полностью одинаковые результаты на разном оборудовании.
В официальной документации PyTorch прямо сказано:
“Completely reproducible results are not guaranteed across PyTorch releases, individual commits, or different platforms.”
PyTorch — Reproducibility
Перевод: «Полная воспроизводимость результатов не гарантируется между версиями PyTorch, отдельными коммитами и различными платформами».
Это особенно важно, когда участники сообщества сравнивают результаты обучения на разных GPU или версиях CUDA.
Если вам нужно обсудить результаты эксперимента, укажите не только итоговую метрику, но и методику её получения.
Какие бенчмарки полезны для LLM-разработчика
Универсальный рейтинг моделей не всегда помогает выбрать решение для реального продукта.
Например, высокая оценка на англоязычном тесте не гарантирует аналогичного качества на русскоязычных юридических документах или запросах пользователей конкретного сервиса.
Для сравнения лучше использовать набор задач, приближенный к будущему применению модели.
При этом качество и производительность следует оценивать отдельно.
Метрики качества: точность выполнения задачи, соответствие эталону, доля ответов с подтверждёнными источниками, успешность выполнения сценария.
Метрики производительности: TTFT (время до первого токена), скорость генерации, задержка запроса, throughput, потребление памяти.
Сравнивать эти показатели имеет смысл только при сопоставимых условиях нагрузки, модели, длине контекста и конфигурации.
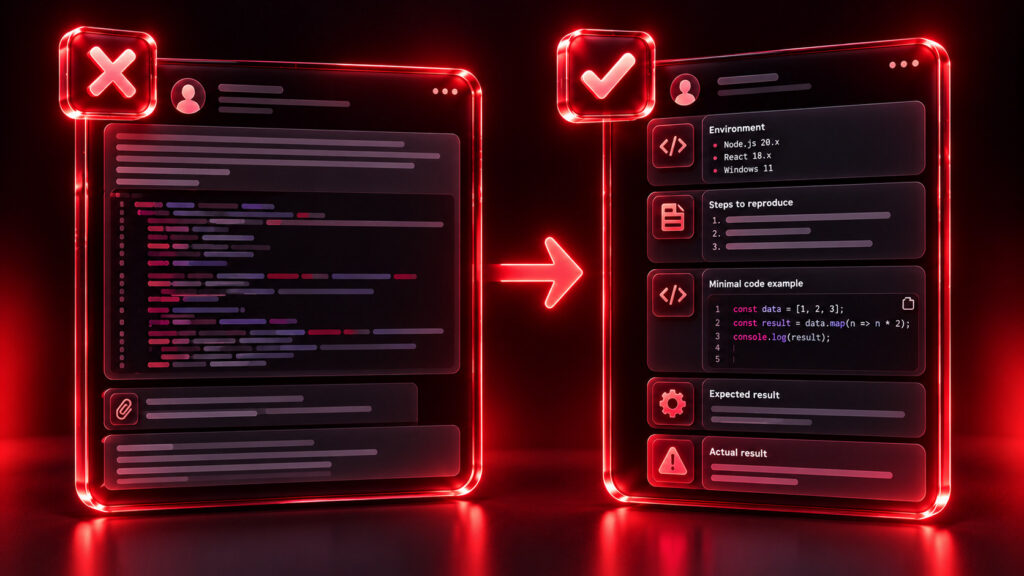
Как правильно задать вопрос AI- или ML-разработчикам
Хорошее техническое сообщение должно позволять другому специалисту понять окружение, воспроизвести проблему и проверить гипотезы.
Шаблон обращения
Задача: что именно разрабатывается — классификатор, RAG, чат-бот, локальный LLM-сервис или система обучения.
Окружение: версии Python, PyTorch, Transformers, CUDA и других компонентов.
Модель: точный идентификатор, ревизия и формат весов.
Оборудование: GPU, объём VRAM, при необходимости CPU и RAM.
Конфигурация: основные параметры обучения или инференса.
Ожидаемый результат: что система должна делать.
Фактический результат: ошибка, измерение или наблюдаемое поведение.
Что проверено: уже исключённые причины.
Вопрос: в каком именно компоненте или предположении требуется помощь.
Пример хорошего технического вопроса
Условный пример оформления, не описание подтверждённой ошибки конкретной версии.
Запускаю квантованную LLM через vLLM на одном GPU.
При одиночных запросах скорость приемлемая, но с ростом числа параллельных запросов заметно увеличивается время до первого токена.
Зафиксировал версию движка, идентификатор модели, формат весов, параметры batching и длину входного контекста.
Проверил загрузку GPU и потребление видеопамяти. Ошибок OOM нет.
Какие метрики scheduling и prefill стоит сравнить, чтобы локализовать источник задержки?
Такой вопрос гораздо полезнее сообщения «vLLM работает медленно».
Как безопасно публиковать промпты, датасеты и результаты
В ML-разработке конфиденциальная информация может находиться не только в коде, но и в данных для обучения, документах RAG и самих запросах к модели.
Поэтому перед публикацией примеров необходимо проверить:
- API-ключи и токены доступа.
- Приватные репозитории и внутренние адреса.
- Персональные данные пользователей.
- Закрытые датасеты и их лицензии.
- Системные промпты, содержащие коммерческие сведения.
- Логи вызовов инструментов и пользовательские диалоги.
- Внутренние документы, попавшие в результаты retrieval.
Безопасная альтернатива: создать синтетический пример, сохраняющий структуру проблемы.
Для RAG это могут быть три коротких вымышленных документа, один вопрос и ожидаемый источник ответа.
Для fine-tuning — небольшой искусственный набор примеров в том же формате, что и рабочие данные.
Для инференса — обезличенная команда запуска и технические метрики без секретов.
Не считайте данные безопасными только потому, что из них удалены имена. Иногда информация остаётся узнаваемой по содержимому документов, числам или уникальным формулировкам.
Если материалы защищены NDA, необходимо соблюдать условия доступа и публикации.
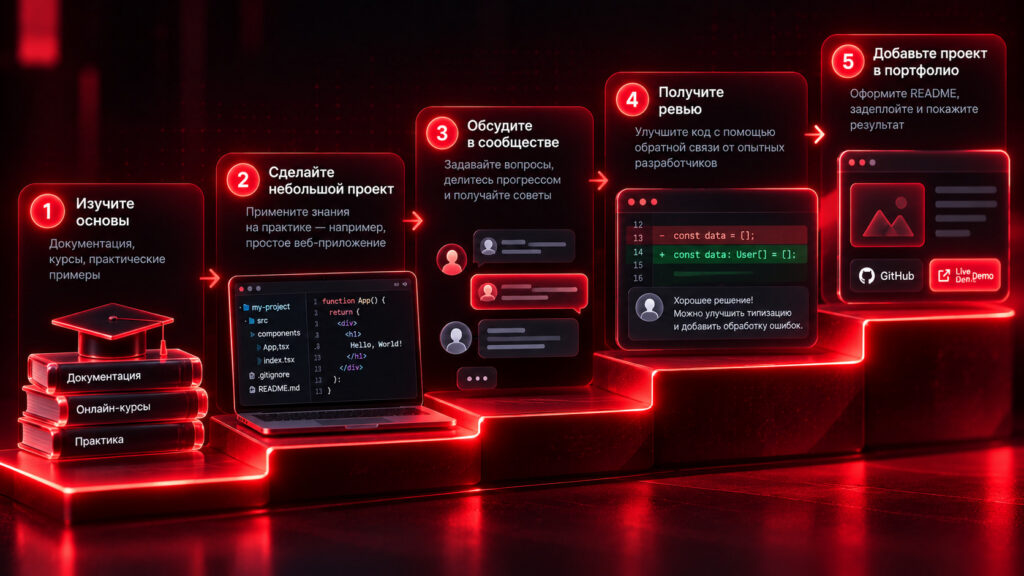
Сообщества для новичков, ML-инженеров и исследователей
Выбор профессионального сообщества зависит также от уровня подготовки.
Начинающим специалистам
Для старта полезны ODS, учебные программы и общие ML-чаты с понятными правилами.
Вопросы по основам Python, математике, scikit-learn и PyTorch лучше сопровождать собственным примером.
Вместо просьбы «объясните машинное обучение с нуля» полезнее спросить, почему конкретный способ валидации не подходит вашему датасету.
ML- и LLM-инженерам
Практикующим разработчикам стоит выбирать площадки по рабочему стеку: Hugging Face, PyTorch, vLLM, llama.cpp, NLP или MLOps.
Обращайте внимание на качество обсуждений: приводят ли участники замеры, конфигурации и проверяемые объяснения.
Исследователям
Исследовательские сообщества полезны для обсуждения статей, архитектур моделей, статистической корректности и воспроизводимости.
Для таких задач подойдут ODS, Hugging Face Research, PyTorch Forums, Kaggle Discussions и тематические reading groups.
При обсуждении научной публикации лучше указывать конкретное утверждение авторов, которое вы хотите проверить.
Как определить качество AI-сообщества
Количество участников или подписчиков не гарантирует техническую экспертизу.
Перед вступлением проверьте несколько признаков:
- Соответствие специализации. В группе действительно обсуждают ваш стек.
- Качество аргументации. Участники приводят код, измерения и ссылки на документацию.
- Актуальность. Есть недавние содержательные вопросы.
- Модерация. Технические дискуссии не тонут в рекламе.
- Культура безопасности. Не требуют передавать секреты и приватные датасеты.
- Результативность. Авторы возвращаются с итогами диагностики и исправления.
Особенно осторожно относитесь к группам, где регулярно обещают гарантированно улучшить любую модель или добиться высокой точности без анализа данных и методики.
Для инженерного сообщества важнее воспроизводимые результаты, чем громкие заявления.
Частые вопросы об AI- и ML-сообществах
Где найти русскоязычный чат по машинному обучению?
Можно начать с Machine Learning Chat, Natural Language Processing или сообщества ODS.ai. Выбор зависит от того, интересуют ли вас классический ML, NLP или разработка моделей.
Где общаются разработчики LLM и RAG?
Профессиональные обсуждения проходят в NLP-сообществах, ODS и на площадках конкретных инструментов. Для работы с Transformers полезен Hugging Face Forum, для серверного инференса — vLLM Forum, для локального запуска — llama.cpp Discussions.
Есть ли официальный форум разработчиков PyTorch?
Да. PyTorch Forums — официальная площадка для обсуждения кода, обучения нейросетей, ошибок CUDA и других технических вопросов.
Где обсудить локальный запуск Llama, Qwen и других моделей?
Начните с сообщества используемого движка — например, llama.cpp или vLLM. В вопросе укажите точную модель, формат весов, аппаратное обеспечение и конфигурацию запуска.
Чем сообщество AI-разработчиков отличается от чата пользователей нейросетей?
В профессиональных сообществах обсуждают архитектуры моделей, обучение, инференс, оценку качества и разработку приложений. Пользовательские группы чаще посвящены готовым AI-сервисам, промптам, генерации изображений и повседневным сценариям использования.
Где искать помощь с fine-tuning?
Для технических вопросов по Transformers, PEFT, токенизаторам и обучению моделей подойдёт Hugging Face Forums. Для ошибок PyTorch и GPU — PyTorch Forums. Методологию датасетов и валидации можно дополнительно обсуждать в ML-сообществах.
Где найти сообщество для изучения AI с нуля?
Можно использовать образовательные материалы ODS, курсы и раздел Beginners на Hugging Face Forums. При выборе сообщества обратите внимание на отношение к начинающим и наличие понятных учебных материалов.
Как получить помощь по RAG, не раскрывая внутренние документы?
Создайте искусственные документы с аналогичной структурой, покажите запрос, результаты поиска и ожидаемый ответ. Не отправляйте закрытые файлы или реальные пользовательские переписки.
Что делать, если в AI-чате никто не отвечает?
Проверьте, соответствует ли вопрос тематике группы. Добавьте версии компонентов, минимальный пример, точный симптом и результаты диагностики. При проблеме с конкретной библиотекой перейдите в официальный форум или GitHub Discussions проекта.
Вывод: какое AI-сообщество выбрать
Полезное сообщество разработчиков искусственного интеллекта — это не обязательно самая крупная группа. Важнее, чтобы участники работали с похожими задачами и могли обсуждать их на нужном техническом уровне.
Для общего машинного обучения подойдут ODS и Telegram-чаты ML-специалистов. Для NLP и LLM — профильные группы и Hugging Face Forums. Для PyTorch, локального инференса и серверного обслуживания моделей лучше обращаться к сообществам конкретных инструментов.
Не стоит вступать сразу в десятки групп. Практичнее использовать несколько точек входа: одно русскоязычное профессиональное сообщество, официальный форум основного инструмента и площадку для исследований или обучения.
Перед обращением сформулируйте задачу, подготовьте воспроизводимый пример и отделите техническую ошибку от проблемы качества модели. Это помогает получить не просто совет, а проверяемый путь к решению.
Для поиска дополнительных групп по AI, ML, Python и другим направлениям разработки посмотрите раздел IT-чатов CommyX. Более широкий выбор профессиональных Telegram-сообществ доступен в каталоге Telegram-чатов.